Decision-grade blueprints · Deel 3 van 4
Onzekerheid tonen zonder confidence score
Wanneer 87% niets zegt
Een confidence score ziet er precies uit en zegt weinig. Wat wel werkt: tonen waarop een bevinding steunt, en wat er moet gebeuren als die grond zwak is.
Dit is één van vier artikels over decision-grade blueprints: beelden van AI-producten die goed genoeg zijn om er beslissingen op te nemen, nog voor er gebouwd wordt.
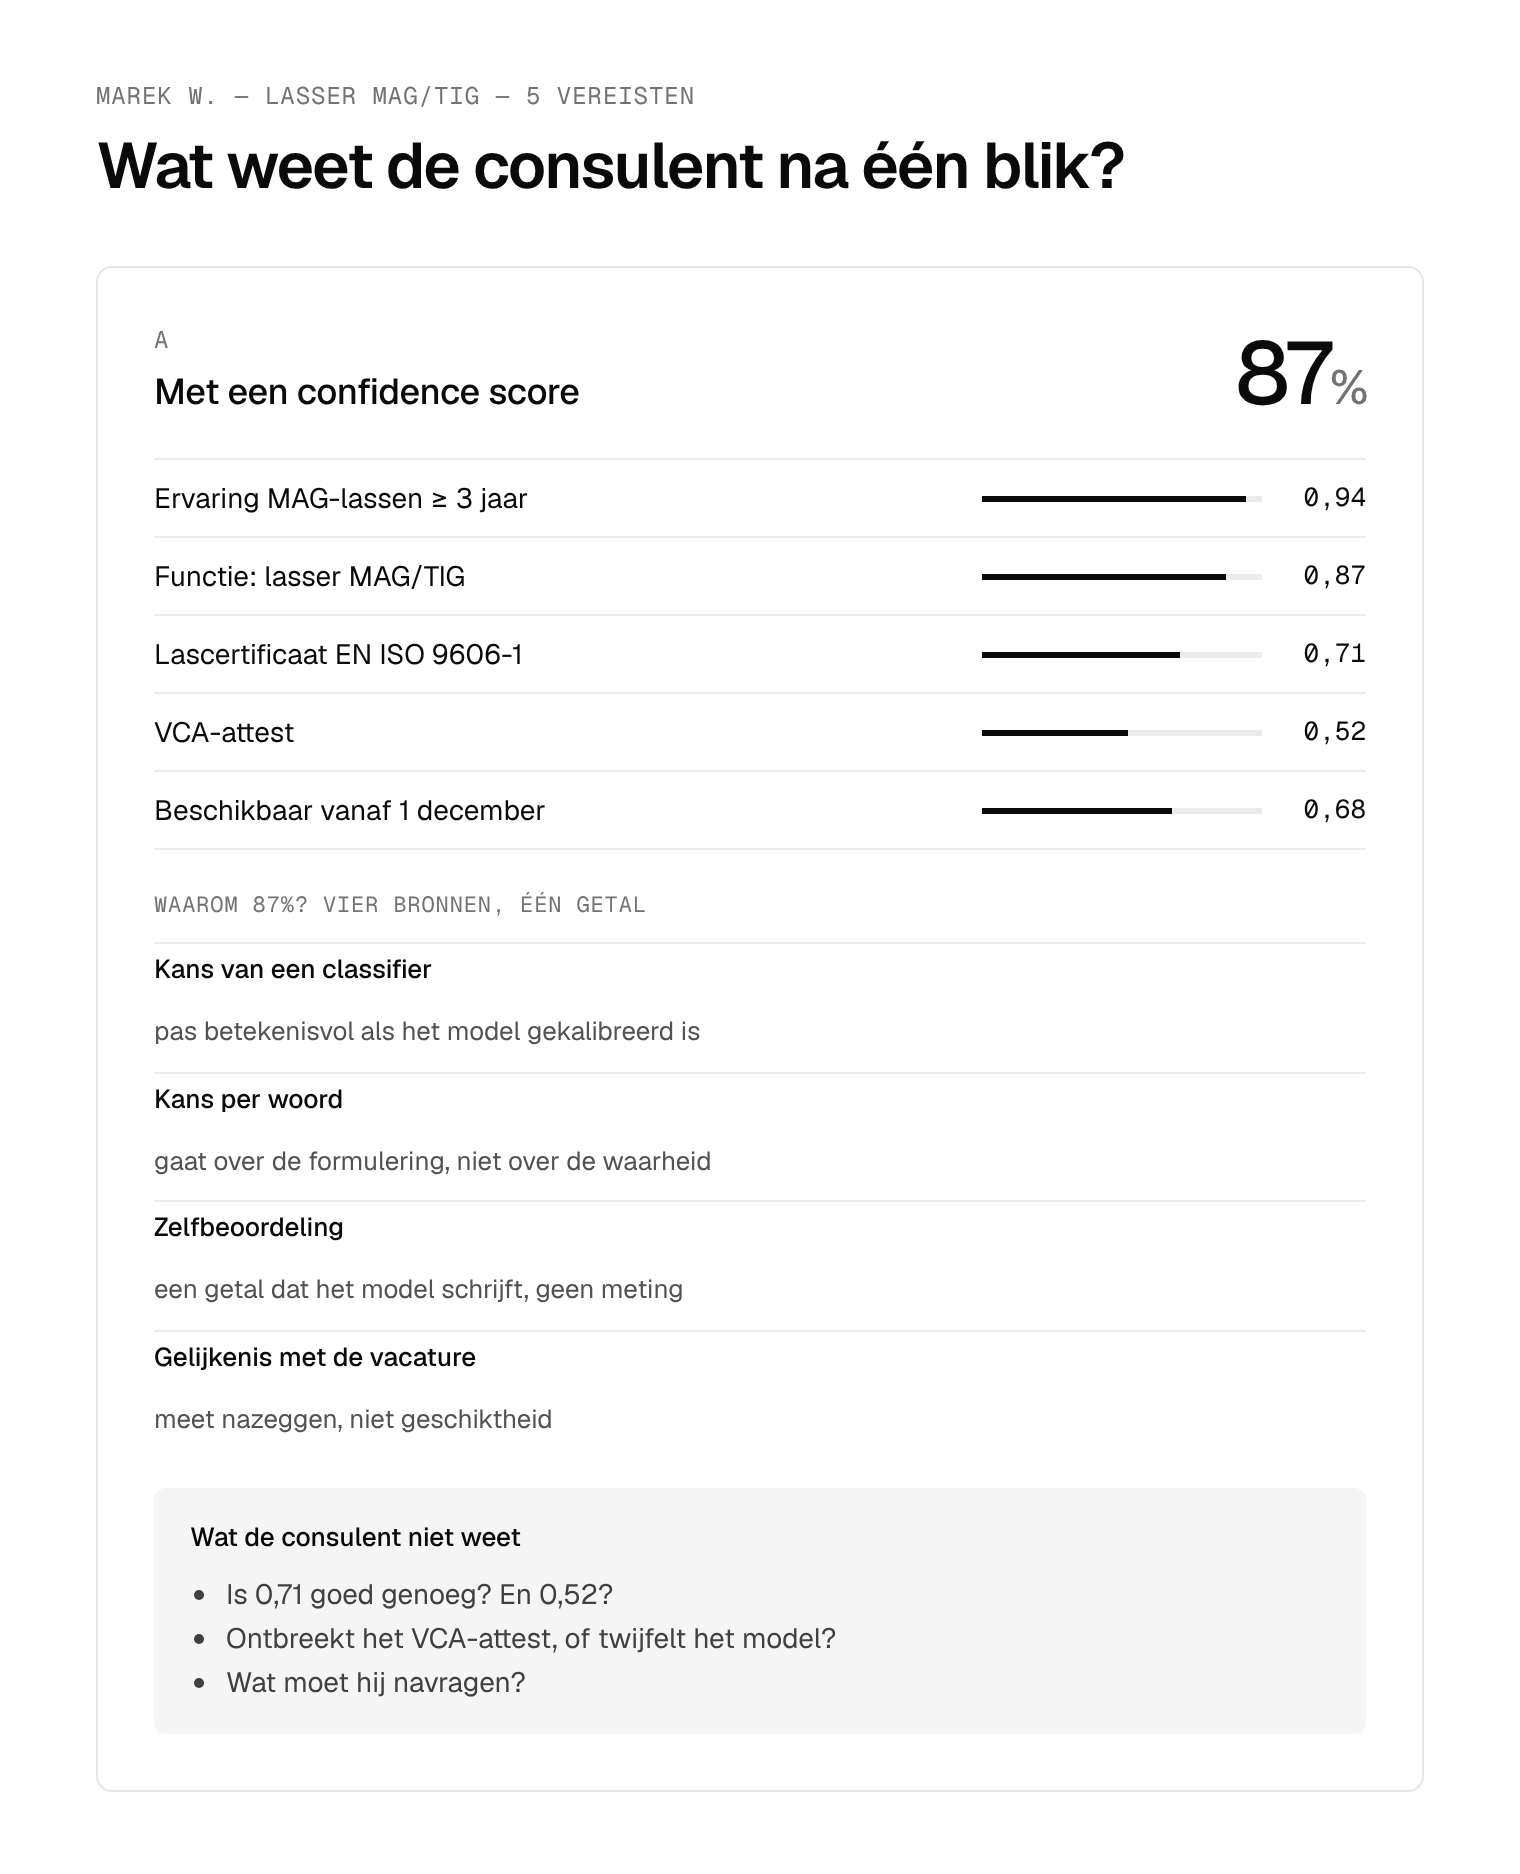
Woensdag, half negen. Victor heeft dertig dossiers te bekijken voor de middag. Stel dat bovenaan elk dossier een getal staat. Marek, de lasser met het Poolse cv: Match: 87%. De kandidaat erna: 84.
Wat moet Victor daarmee? Is 87 goed? Is het beter dan 84? Betekent het dat Marek in 87 van de 100 gevallen een goede lasser blijkt? Of dat het model voor 87 procent zeker is van iets, en zo ja, van wat precies: de vertaling, het diploma, de ervaring, of alles samen?
Het eerlijke antwoord is meestal: dat weet niemand aan tafel. Ook de bouwers niet altijd. En toch staat dat getal er, groot en precies, alsof het iets meet.
Wat er achter zo'n getal zit
Een “confidence score” klinkt als één ding. In de praktijk zijn het er minstens vier.
Een kans van een classificatiemodel. Een model dat leerde kiezen tussen “geschikt” en “niet geschikt” geeft per keuze een getal tussen 0 en 1. Dat is pas een kans als het model gekalibreerd is: als van alle gevallen met 0,8 ook echt ongeveer 80 procent klopt. Moderne neurale netwerken zijn vaak te zeker van zichzelf, zo toonden Guo en collega's al in 2017.
Een kans per woord. Een taalmodel kiest elk volgend woord met een zekere waarschijnlijkheid. Daaruit kan je afleiden hoe vast het model stond bij een formulering. Maar een zekere formulering is nog geen ware bewering. Een model kan heel zeker zijn dat “spawacz” lasser betekent, en toch fout zitten over welk certificaat daarbij hoort.
Een zelfbeoordeling. Je kan een taalmodel ook gewoon vragen hoe zeker het is. Dan krijg je een getal dat het model schrijft, zoals het elk ander woord schrijft. Xiong en collega's lieten in 2024 zien dat zulke uitspraken overmoedig zijn en zich ophopen tussen 80 en 100 procent, ook als het antwoord fout is.
Een gelijkenis. Veel “matchscores” in werving zijn geen kans maar een afstand: hoe dicht een cv bij een vacature ligt. Dat meet gelijkenis, geen geschiktheid. Marek, die zijn ervaring in het Pools en in andere woorden beschrijft, verliest dan al snel van wie de advertentie bijna woordelijk overnam.
Wie niet weet welk van de vier getallen er staat, kan niet ontwerpen wat de gebruiker ermee moet doen. En precies die vraag wordt in veel projecten nooit gesteld, omdat het getal al in de demo zat.
Achter de schermen mag een systeem gerust rekenen met gekalibreerde kansen. De vraag in dit artikel is een andere: wat toon je aan wie moet beslissen?
Waarom een getal alleen niet volstaat
Het probleem is niet het getal zelf, maar een getal zonder uitleg over wat het meet, hoe betrouwbaar het is en wat je ermee moet doen. Dan gaan drie dingen mis.
Een getal nodigt uit tot rangschikken. Wie 87, 84 en 79 ziet, leest een volgorde. Zonder informatie over kalibratie en foutmarge weet niemand of dat verschil van drie punten iets betekent. Het scherm doet alsof dat zo is.
Een getal roept een drempel op. Vroeg of laat vraagt iemand: vanaf hoeveel nemen we iemand mee? Dan wordt 80 een grens die niemand zo besliste, en verdwijnt een kandidaat met 79 zonder dat iemand nog kijkt.
In werving is dat precies het soort automatische uitsluiting dat je wil vermijden, ook juridisch.
Een getal verbergt waar de twijfel zit. “87%” zegt niet waarover het model twijfelt. Bij Marek zit de onzekerheid niet in zijn ervaring, maar in één half leesbaar certificaat. Een consulent die dat weet, belt Marek en vraagt het. Een consulent die alleen 87 ziet, kan het getal geloven of negeren.
En mensen volgen een systeem gretiger naarmate het zekerder overkomt. Een precies getal komt heel zeker over, zeker met een decimaal. Het ontwerp werkt dan tegen het menselijk toezicht in dat je net wilde organiseren.
De casus in deze reeks is fictief: een illustratief ontwerp, geen gevalideerd systeem. De mensen, het bedrijf en de data bestaan niet.
Waarop het steunt
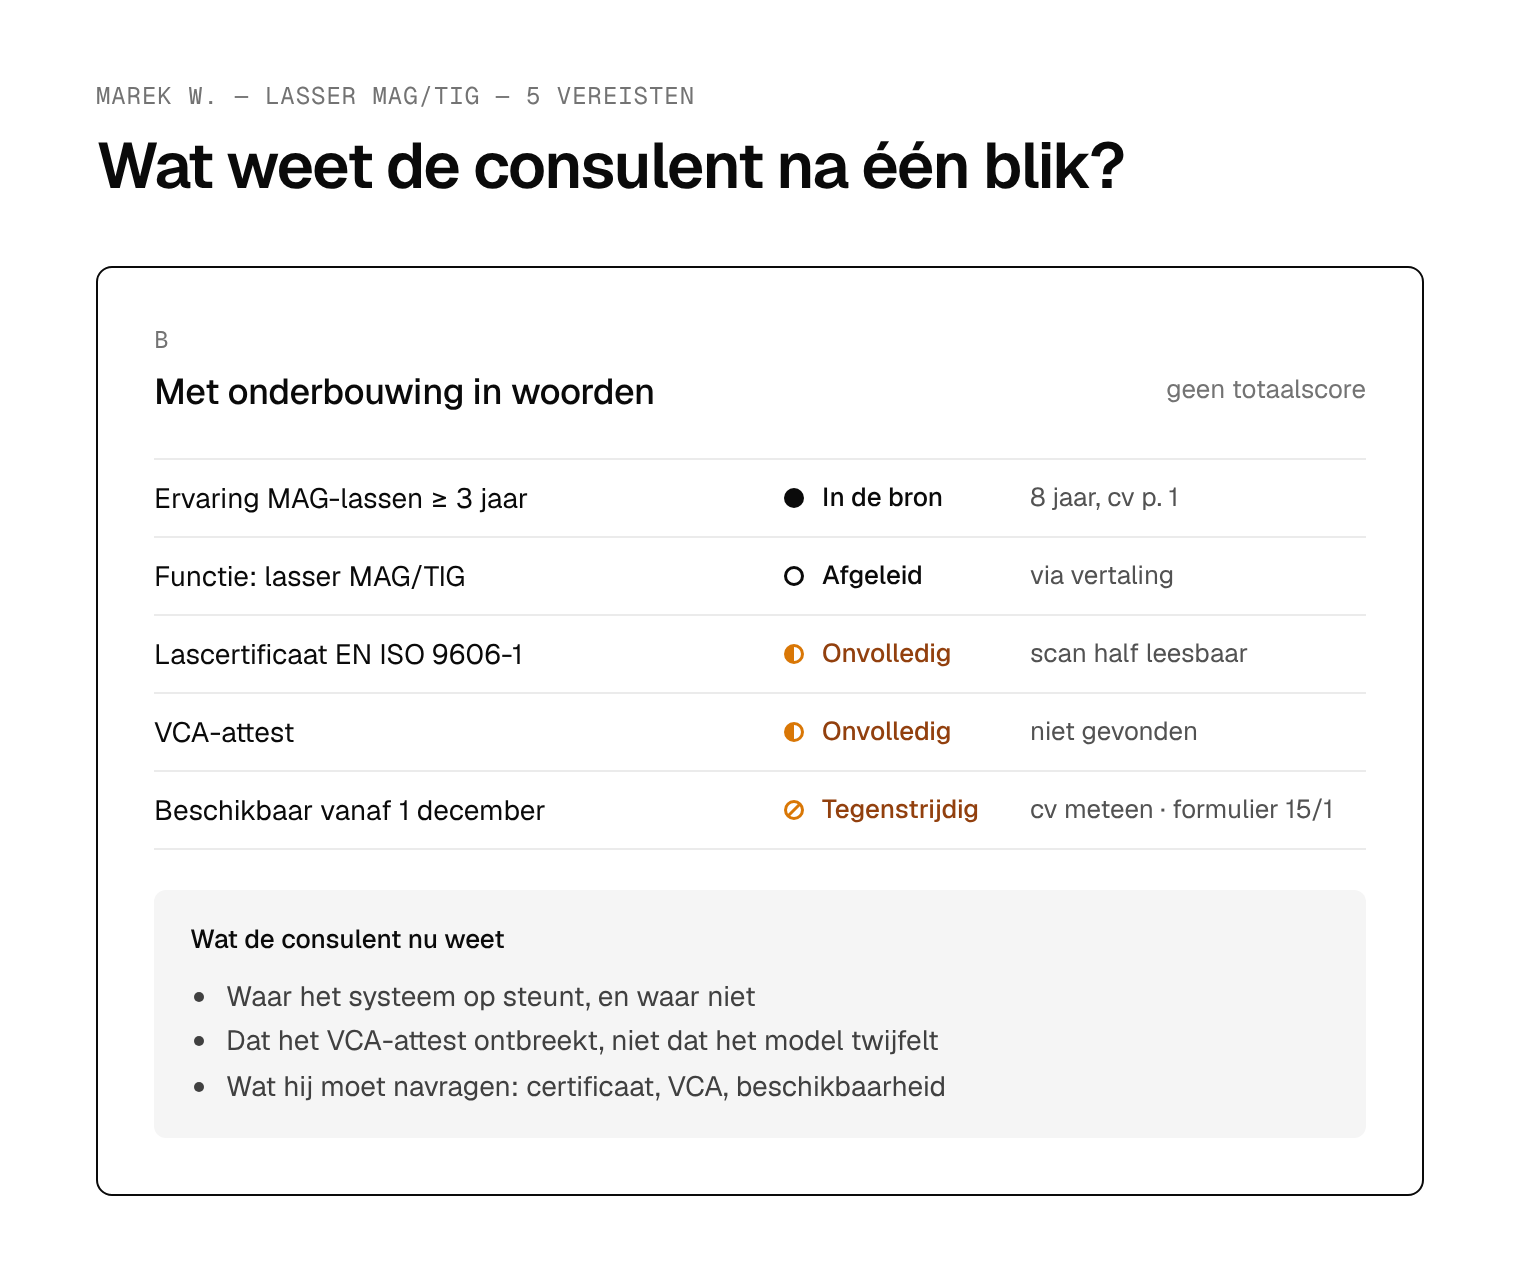
Op het scherm van Victor staat daarom geen niveau van zekerheid. Een model levert strikt genomen geen zekerheid, maar een graad van geloof. En zelfs een goede graad van geloof vertelt Victor niet wat hij moet doen. Wat het systeem wel eerlijk kan tonen, is waarop een bevinding steunt. Dat zijn drie vragen, los van elkaar, bij elke bevinding afzonderlijk.
| Vraag | Mogelijke antwoorden | Wat het systeem doet |
|---|---|---|
| Herkomst: waar komt het vandaan? | In de bron of afgeleid | Toont de bron; bij een afleiding, zoals een vertaling, ook het origineel |
| Bewijs: hoe volledig is het? | Volledig, onvolledig of tegenstrijdig | Onvolledig: neemt de bevinding niet mee in het voorstel en stelt een actie voor. Tegenstrijdig: toont beide bronnen en beslist niet |
| Controle: heeft een mens het nagekeken? | Niet nagekeken, bevestigd of overschreven | Legt vast wie wat deed, met tijdstip en reden |
Bij Marek: zijn acht jaar ervaring staan in de bron, volledig. Zijn functietitel is afgeleid, want vertaald, maar verder volledig. Zijn lascertificaat staat wel in de bron, want er is een scan, maar het bewijs is onvolledig: half leesbaar, zonder norm. Op het scherm komt telkens het zwakste deel in één woord samen; het datamodel bewaart alle antwoorden apart.
Anders dan een getal is elk antwoord gekoppeld aan gedrag.
En de regels erachter leg je samen met de klant vast: staat het letterlijk in de bron, was er een vertaling nodig, is het document volledig, spreken twee documenten elkaar tegen? Dat kan je controleren, en dus ook uitleggen. Een getal van een model meestal niet.
Eén label, vier vragen
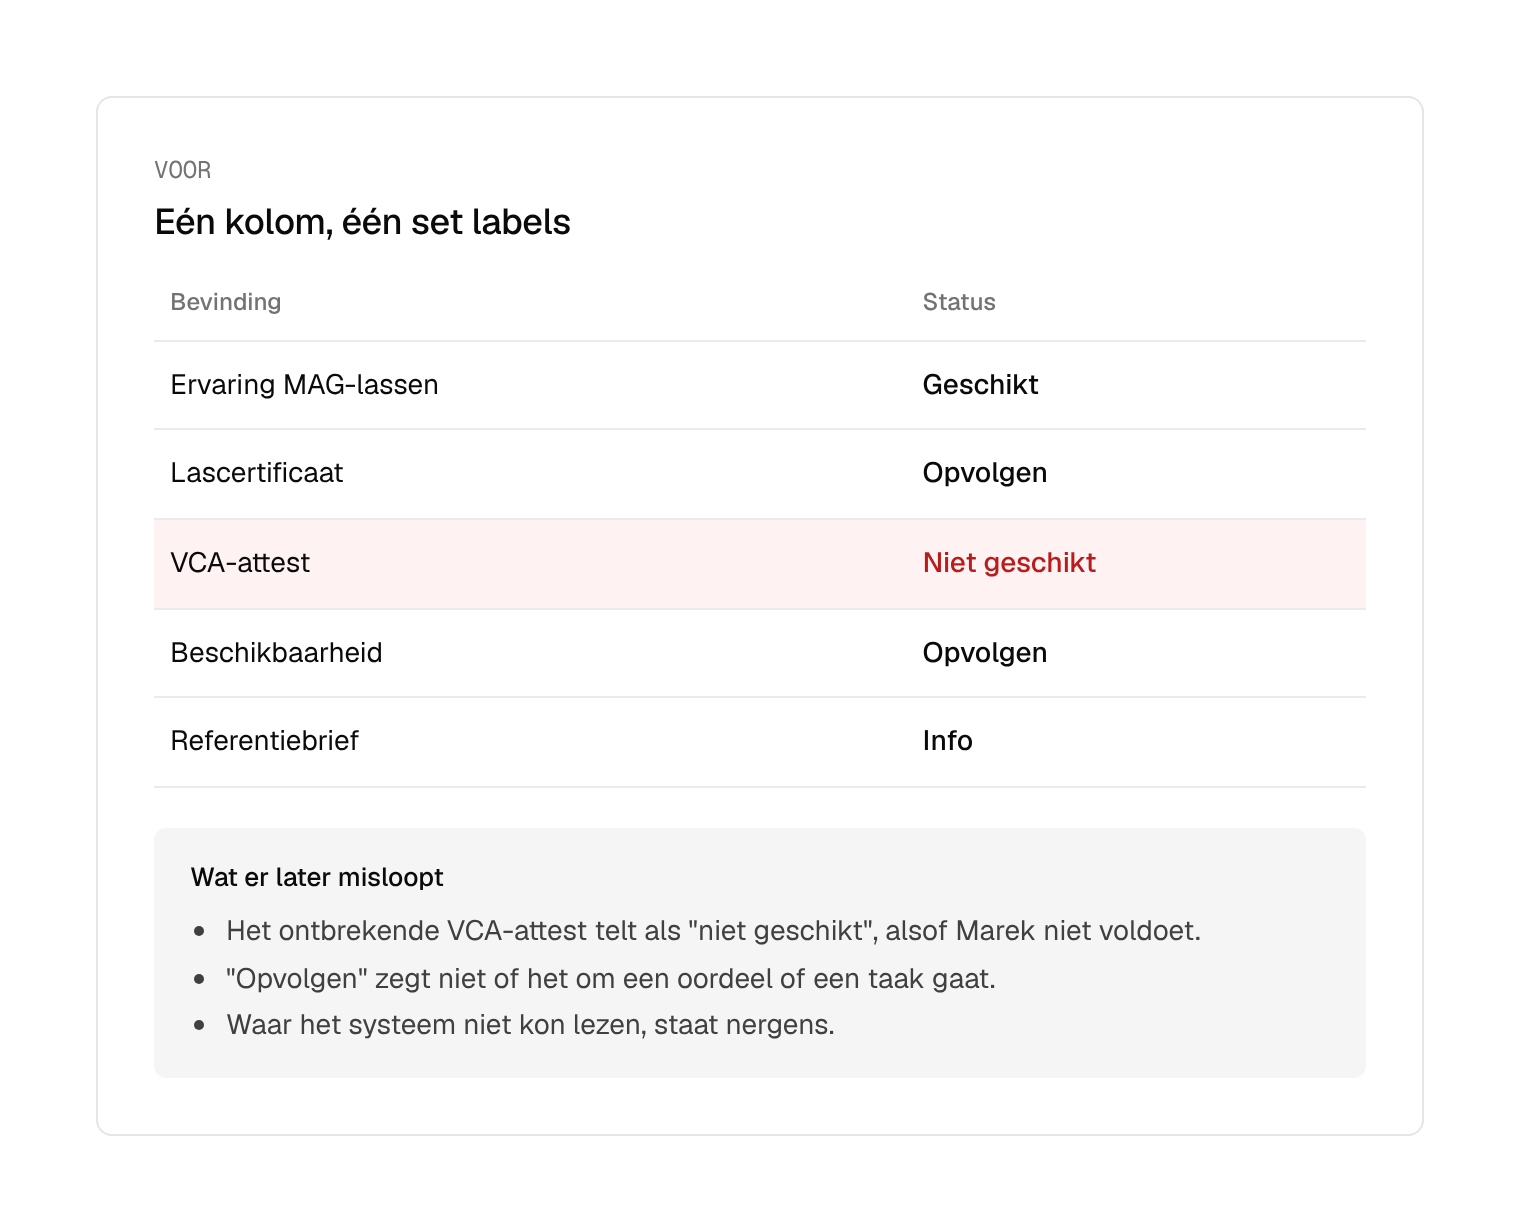
Een patroon dat ik vaak tegenkom: alle uitkomsten van een AI belanden in één kolom met één set labels. Geschikt, Niet geschikt, Opvolgen, Info. Overzichtelijk, tot je kijkt wat er gebeurt. Het VCA-attest van Marek ontbreekt, en dus staat er “niet geschikt”. Niet omdat hij niet voldoet, maar omdat er geen beter vakje was.
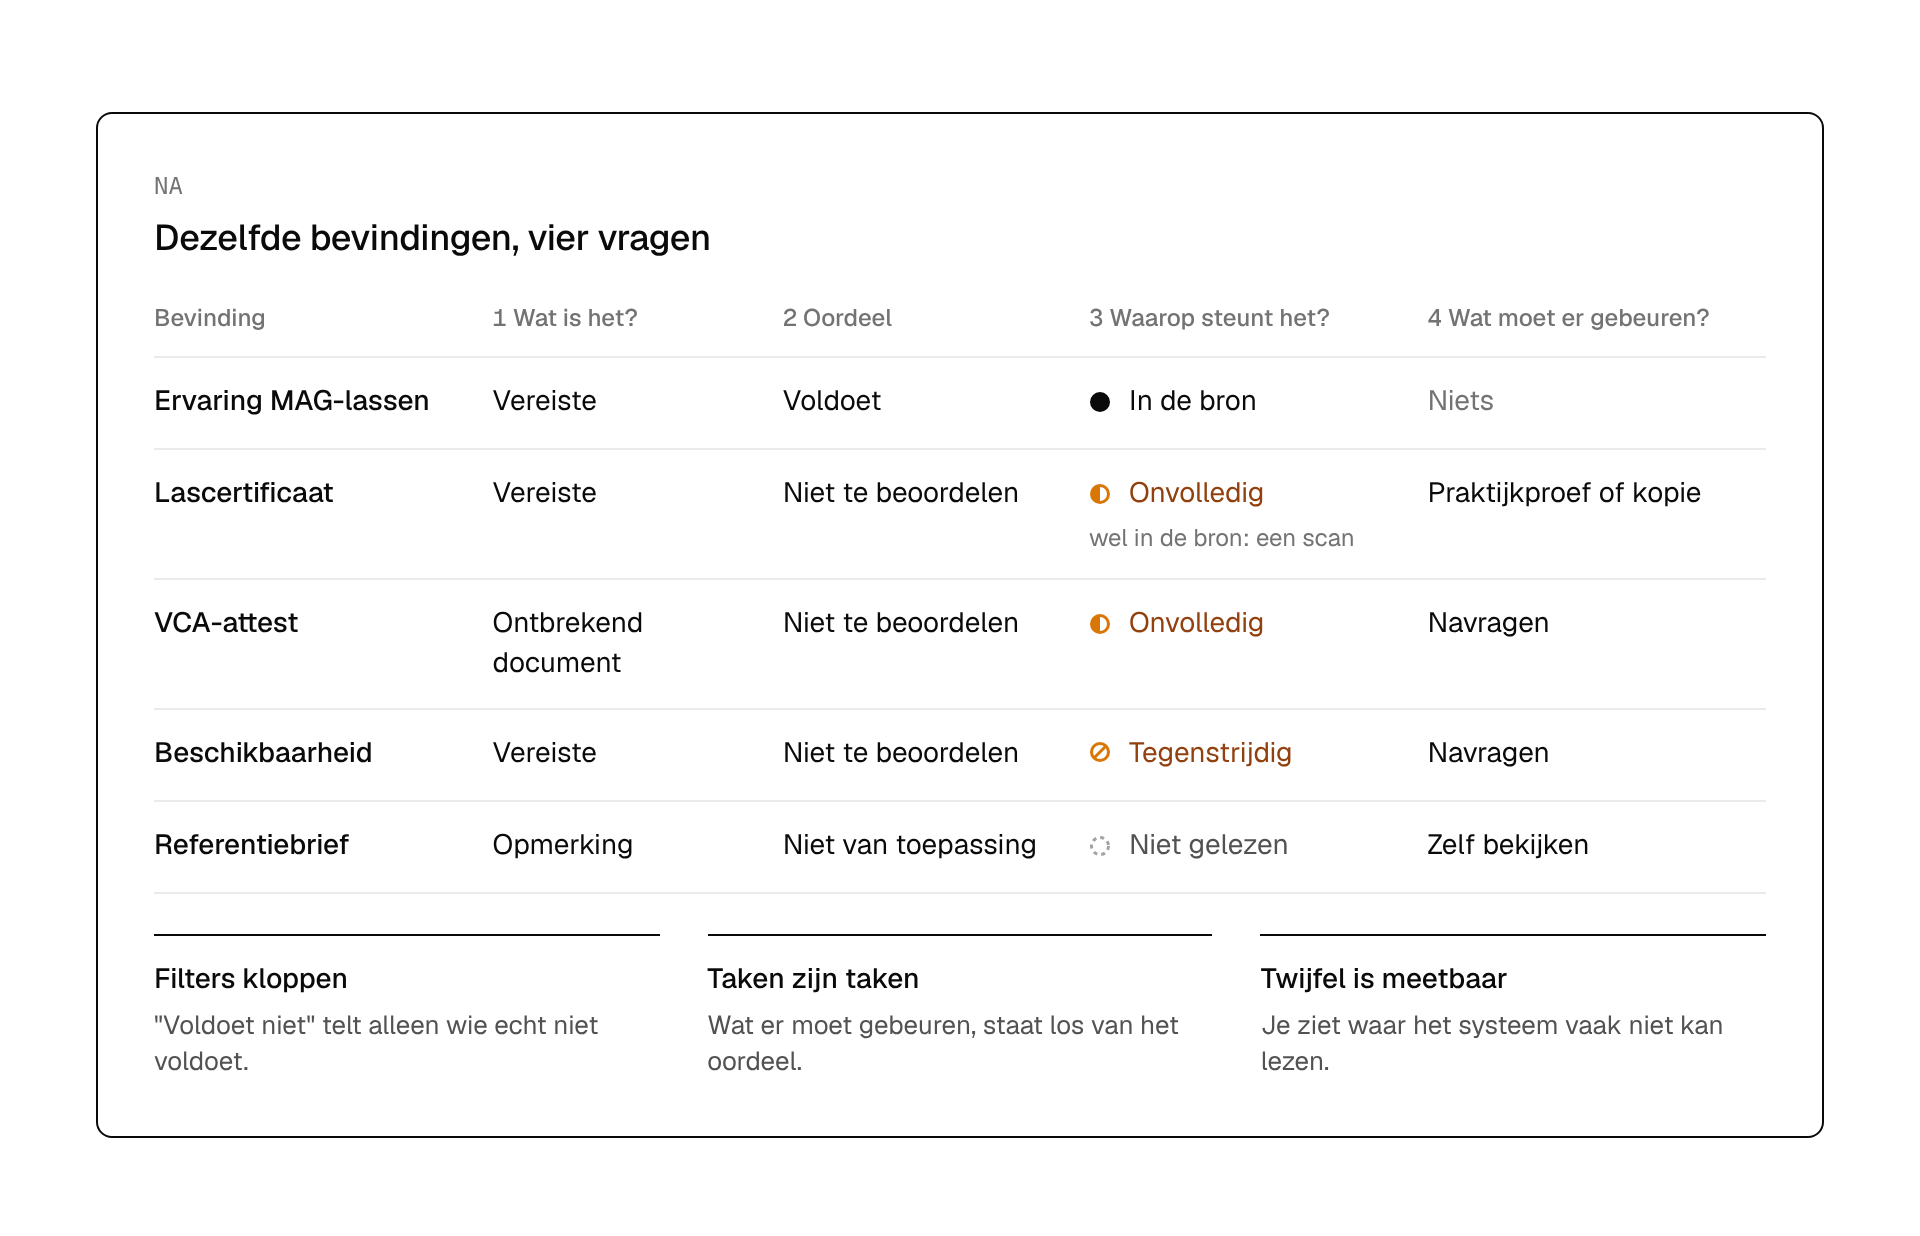
In die ene kolom zitten vier vragen samengeperst: wat is het, wat is het oordeel, waarop steunt het, en wat moet er gebeuren? Een filter op “geschikt” mist wie geschikt lijkt maar nog opgevolgd moet worden. Een rapport dat “niet geschikt” telt, telt ook wie het systeem gewoon niet kon lezen. En wie wil weten waar het model het vaakst twijfelt, vindt dat nergens, omdat twijfel geen eigen plek kreeg.
Uit elkaar gehaald levert dat geen vier kolommen op, wel een rustiger beeld: Victor ziet in één oogopslag wat in orde is en wat nog werk vraagt. En zo'n beslissing moet vroeg vallen. Een label is snel getekend en snel gebouwd. Het datamodel erachter later uit elkaar halen, is een ander verhaal: dan herzie je ook alle rapporten, filters en afspraken die er intussen op gebouwd werden.
Twijfel erft door
Een AI neemt zelden één beslissing. Het neemt er een reeks, en elke stap bouwt op de vorige: het cv inlezen, de taal herkennen, vertalen, de onderdelen herkennen, diploma's vergelijken, ervaring vergelijken, de vereisten afvinken, een voorstel maken.
Neem Mareks certificaat. De scan is half leesbaar. De vertaling die daarop volgt, kan dus niet beter zijn dan wat ze kon lezen. De vergelijking met de vereiste norm ook niet, hoe overtuigend die op zich ook lijkt. In veel systemen gebeurt dan iets merkwaardigs: elke stap rapporteert zijn eigen zekerheid, en de laatste stap toont alleen de zijne. 0,62, dan 0,91, 0,88, 0,93. Op het scherm: “certificaat: voldoet”. De twijfel is onderweg verdampt.
In de blueprint geldt daarom een regel: een conclusie is nooit beter onderbouwd dan de zwakste stap waarop ze steunt. En het scherm toont waar de zwakte vandaan komt. Niet “certificaat: onvolledig”, maar “certificaat: onvolledig, omdat de scan maar half leesbaar is”. Dan weet Victor wat hij moet oplossen: niet het diploma, maar de scan.
In die keten zijn twee stappen duidelijk zwakker dan de rest: buitenlandse diploma's vergelijken, en vereisten afvinken die niet letterlijk in het cv staan. Dat is de werkelijkheid van zulke systemen. Een blueprint hoort het te tonen, want precies daar moet een mens blijven meekijken.
Het lascertificaat van Marek, door de keten van beslissingen
- 01 Bijlage inlezen0,62Onvolledigscan half leesbaar
- 02 Vertalen0,91Onvolledigovergeërfd van 01
- 03 Diploma vergelijken0,88Onvolledigovergeërfd van 01
- 04 Vereiste afvinken0,93Onvolledigovergeërfd van 01
- Op het schermCertificaat: voldoetCertificaat: onvolledig, omdat de scan half leesbaar isVoorstel: praktijkproef
Alleen het laatste getal haalt het scherm. Dat de scan maar half leesbaar was, is onderweg verdampt.De consulent ziet niet alleen dat er iets wringt, maar ook waar: niet het diploma, maar de scan.
Regel in de blueprintEen conclusie is nooit beter onderbouwd dan de zwakste stap waarop ze steunt.
Ook mensen twijfelen, alleen ziet niemand het
Er is een ongemakkelijke kant aan dit verhaal. We eisen van een AI dat ze haar twijfel toont, en dat is terecht. Maar de consulent die vandaag zonder AI Mareks cv leest, twijfelt ook. Alleen staat die twijfel nergens. Ze zit in een buikgevoel, in de volgorde waarin de cv's binnenkwamen, in hoe laat het is. Ook dat is een score, maar een die niemand kent, die per persoon en per dag verschilt, en die je achteraf niet kan nagaan.
Onderzoek naar menselijk oordeel toont dat al decennia. Professionals die dezelfde dossiers beoordelen, lopen verder uiteen dan ze zelf denken. Vaste beoordelingsregels voorspellen bij selectie meestal minstens even goed als ervaren experts. En praktijktests, waarbij onderzoekers dezelfde cv's onder verschillende namen versturen, tonen dat een naam alleen al de kans op een uitnodiging verandert.
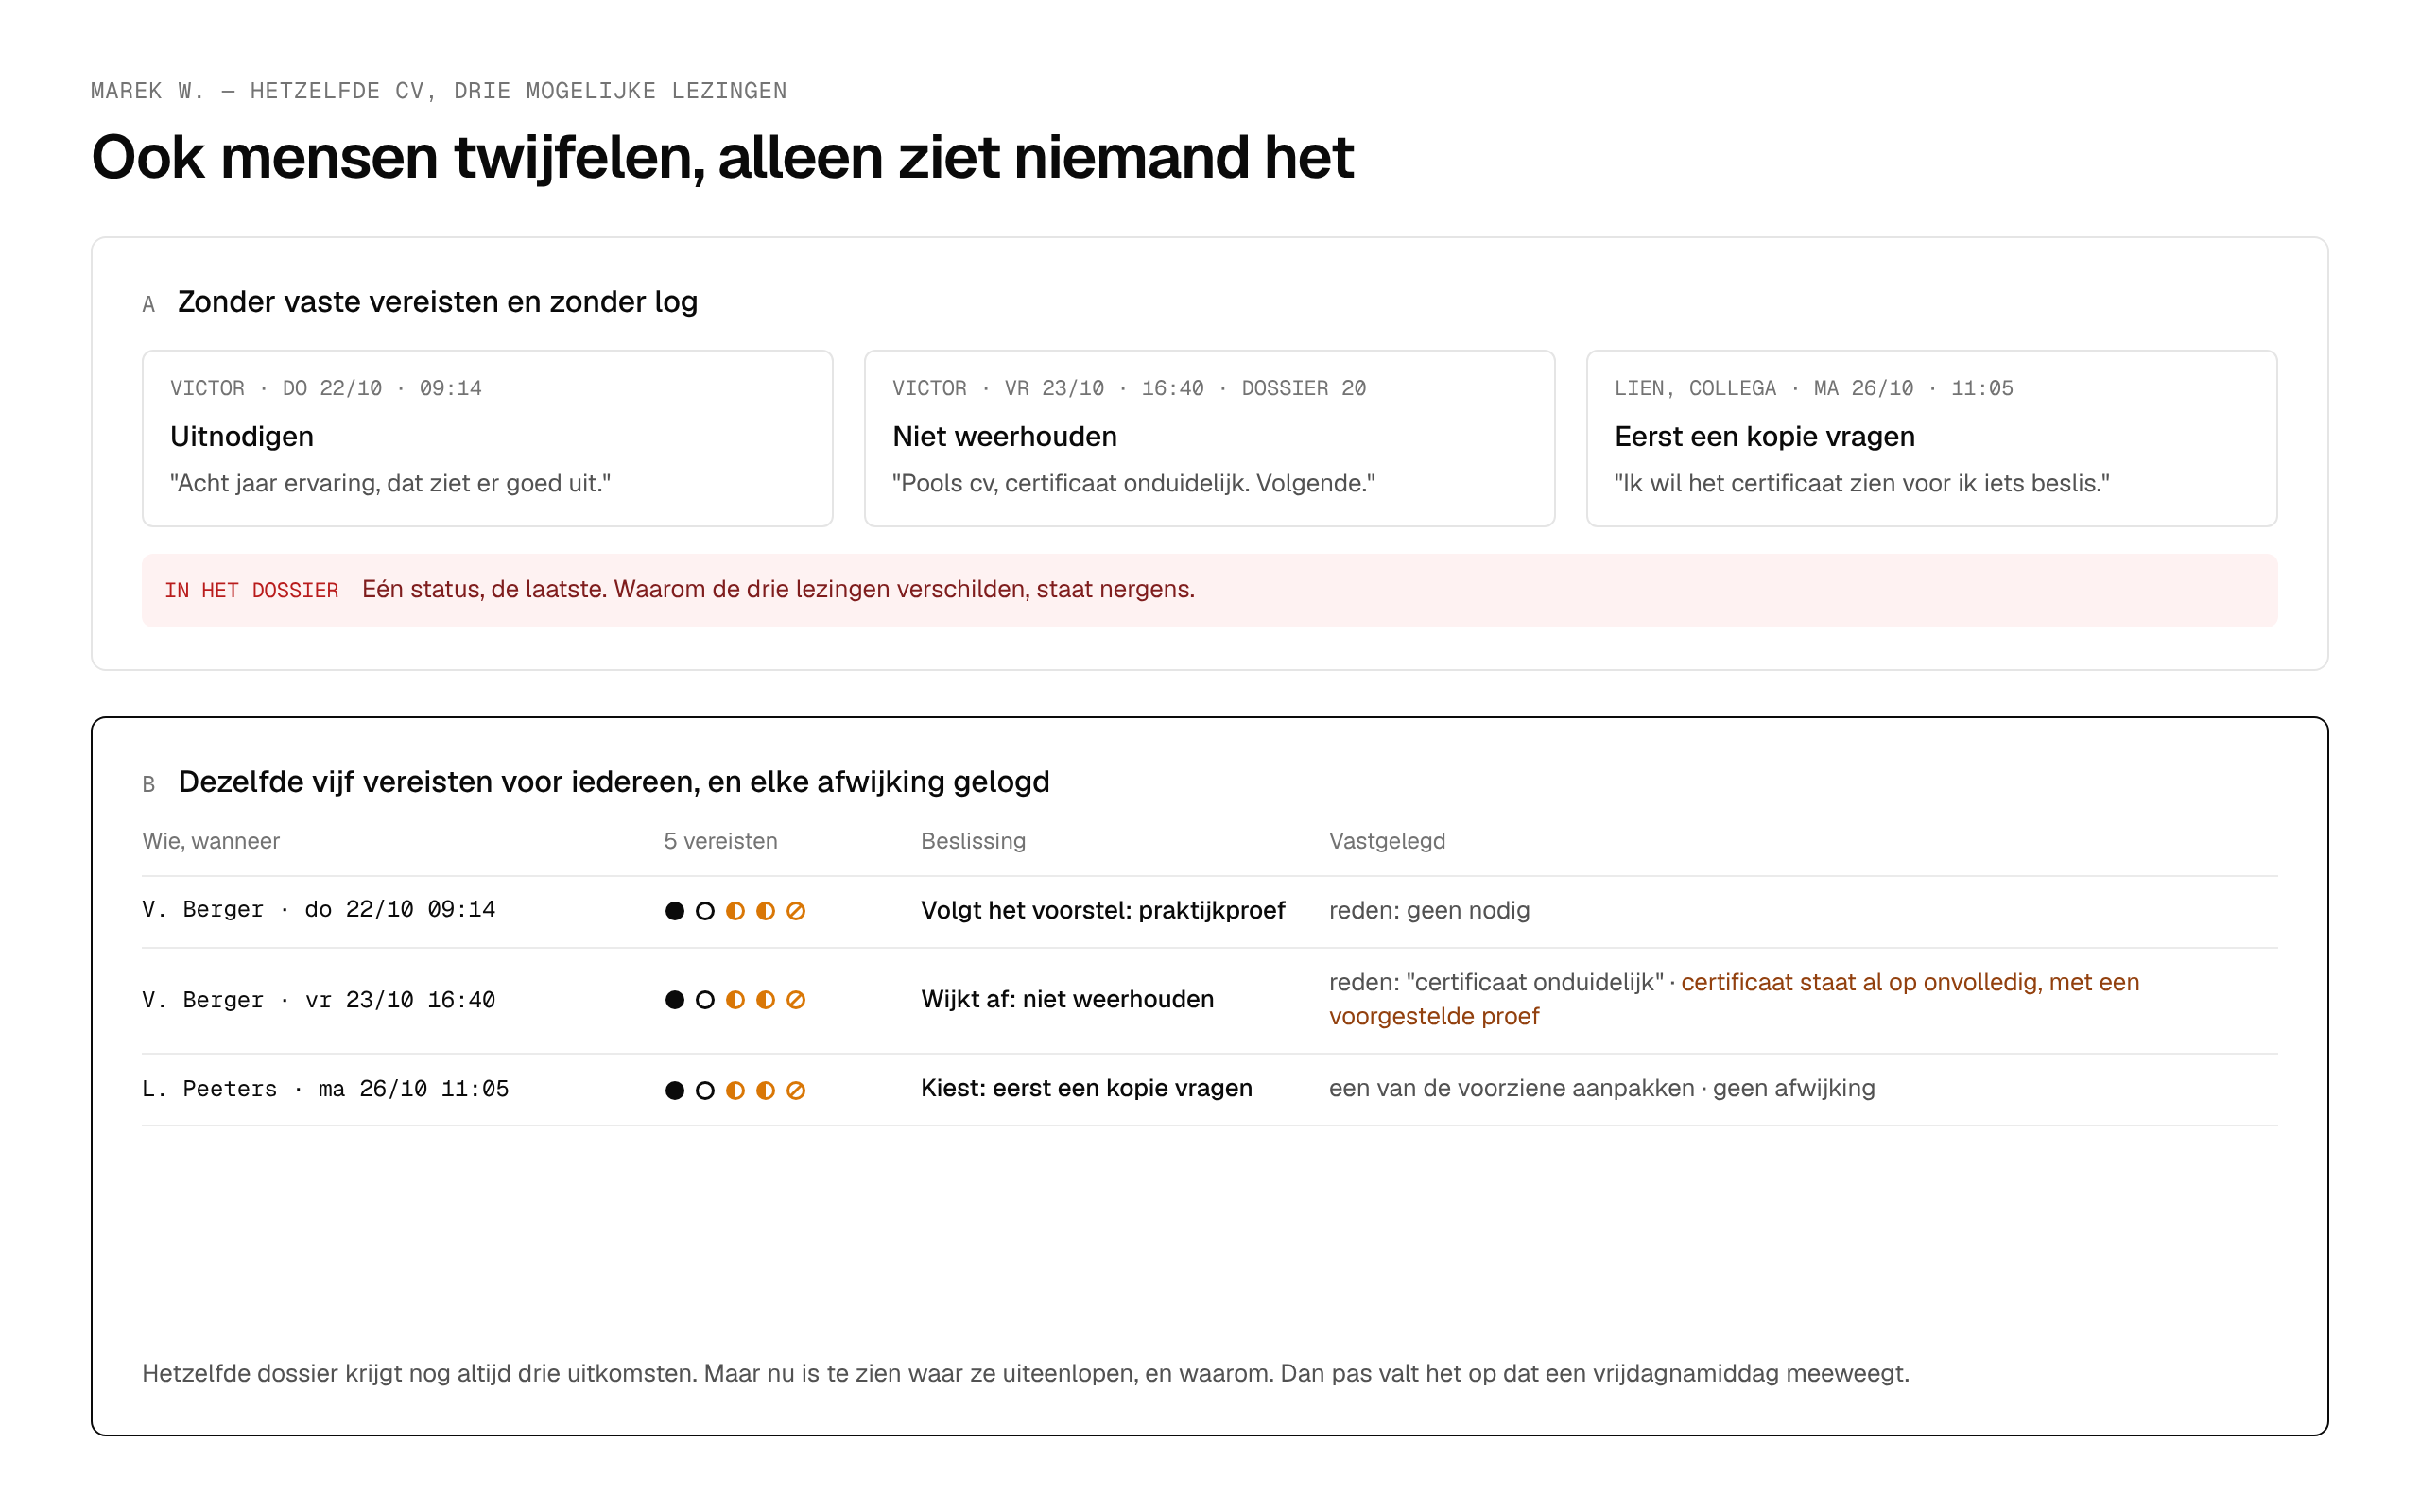
Dat is geen argument om de mens te vervangen, wel om mens en machine elkaars zwakke plekken te laten opvangen. Omdat de machine toont waarop ze steunt, kan Victor haar fouten zien en corrigeren voor ze in het resultaat belanden. Omgekeerd houden de vaste criteria van de machine een deel van Victors eigen ruis tegen: elke kandidaat wordt op dezelfde vereisten getoetst, wat zijn naam ook is en hoe laat het ook is. Dat werkt alleen als die criteria zelf deugen, want ook een model maakt fouten, en die herhalen zich over duizenden kandidaten. Daarom legt het scherm beide vast: waar de machine twijfelt, en waar de mens afwijkt en waarom. Dan pas kan je eerlijk vergelijken.
Twijfel als winst
Goed getoond is onzekerheid meer dan een risico om te beheren. Ze levert vier dingen op die een getal nooit geeft.
Kansen die anders verdwijnen. Een systeem dat alleen op zekerheid stuurt, legt Marek opzij. Een systeem dat zijn twijfel benoemt, stelt een praktijkproef voor.
Processen die zichtbaar worden. Elke “onvolledig” of “tegenstrijdig” met een voorgestelde actie is een vraag aan de organisatie. Wie belt de kandidaat? Wie beoordeelt een buitenlands diploma? Hoe snel moet dat? In veel bedrijven bestaan die processen niet, of alleen in het hoofd van één ervaren consulent.
Data die het systeem beter maakt. Als twijfel een eigen plek krijgt in het datamodel, kan je meten waar ze zit. Twijfelt het systeem vaker bij cv's in bepaalde talen? Bij bepaalde diploma's? Dan weet je waar het model beter moet, en waar een mens structureel moet blijven meekijken. Dat is ook het soort opvolging dat de AI Act vraagt van wie zo'n systeem inzet, bij werving en selectie vanaf december 2027.
Een drempel die het bureau zelf kiest. Eén getal mag blijven, maar niet op het scherm: de drempel. Achter “onvolledig” zit een grens. Vanaf hoeveel twijfel over een gelezen scan of een vertaling markeert EU Connect een bevinding als onvolledig, in plaats van als in de bron? Ze is een afweging tussen extra werk en gemiste fouten, en die afweging hoort bij het bureau, niet in een standaardinstelling van de leverancier. Voor een veiligheidscertificaat ligt ze strenger dan voor een rijbewijs. Daarom krijgt de beheerder een schuifregelaar per type vereiste, die meteen toont hoeveel dossiers bij die stand een taak krijgen. Elke wijziging komt in het log.
Wat dit vraagt van een ontwerper
Geen van deze keuzes is een kwestie van smaak. Ze vragen dat je weet welk getal er onder de motorkap zit, hoe de beslisketen loopt en waar ze zwak is, wat de wet verwacht, en wat Victor om half negen 's ochtends met dertig dossiers echt kan verwerken. En ze vragen een beeld dat er rustig en vanzelfsprekend uitziet, zodat de twijfel helpt en niet afschrikt.
Wie zo werkt, ziet onderweg altijd meer dan waarvoor hij gevraagd werd: een proces dat ontbreekt, een rapport dat niet zal kloppen, een risico dat buiten de opdracht valt. In het laatste artikel van deze reeks gaat het over wat je daarmee doet. Zwijgen is geen optie, stilzwijgend meeleveren evenmin. Er is een derde weg: Gezien, buiten scope.